Du har skrivit sidan, publicerat den och väntat. Den syns ändå inte i Google. Nästan alltid finns svaret i en och samma rapport: Sidindexering (Page indexing) i Google Search Console. Här går jag igenom hur rapporten är uppbyggd, vad varje orsak betyder och vad jag gör åt dem.
Det viktigaste i korthet
- Rapporten Sidindexering visar vilka av sajtens sidor Google har indexerat och varför resten inte är det.
- Alla sidor som saknas i indexet är inte ett problem. Orsaken avgör om du ska göra något.
- Kolumnen Källa visar om problemet ligger hos din sajt eller hos Google.
- När du har rättat ett fel validerar du åtgärden, så följer Google upp och meddelar dig.
När du behöver rapporten
Googles egen hjälpsida säger att en sajt med färre än 500 sidor förmodligen inte behöver den. För en liten sajt räcker det ofta att söka direkt i Google:
site:dindoman.sevisar ett urval av sidorna Google känner till.site:dindoman.se ord1 ord2visar vilka sidor som täcker ett visst ämne.site:dindoman.se/exakt-sidavisar om en specifik sida är indexerad.
För en enskild sida är URL-granskning (URL Inspection) i Search Console snabbast. Den visar indexstatus, senaste crawl och vilken kanonisk URL Google har valt.
Är antalet kända URL:er i rapporten mycket lägre än antalet sidor du faktiskt har, hittar Google inte dina sidor. Då behöver de nås via interna länkar eller en sitemap. Nya sidor tar tid att indexera, och du kan be Google indexera enskilda sidor via URL-granskningen.
Har du en större sajt, eller jobbar med SEO och utveckling, är rapporten ett av de verktyg jag öppnar först. Det hjälper att känna till hur Google Sök fungerar innan du börjar, annars blir siffrorna svåra att tolka.
Så läser du rapporten
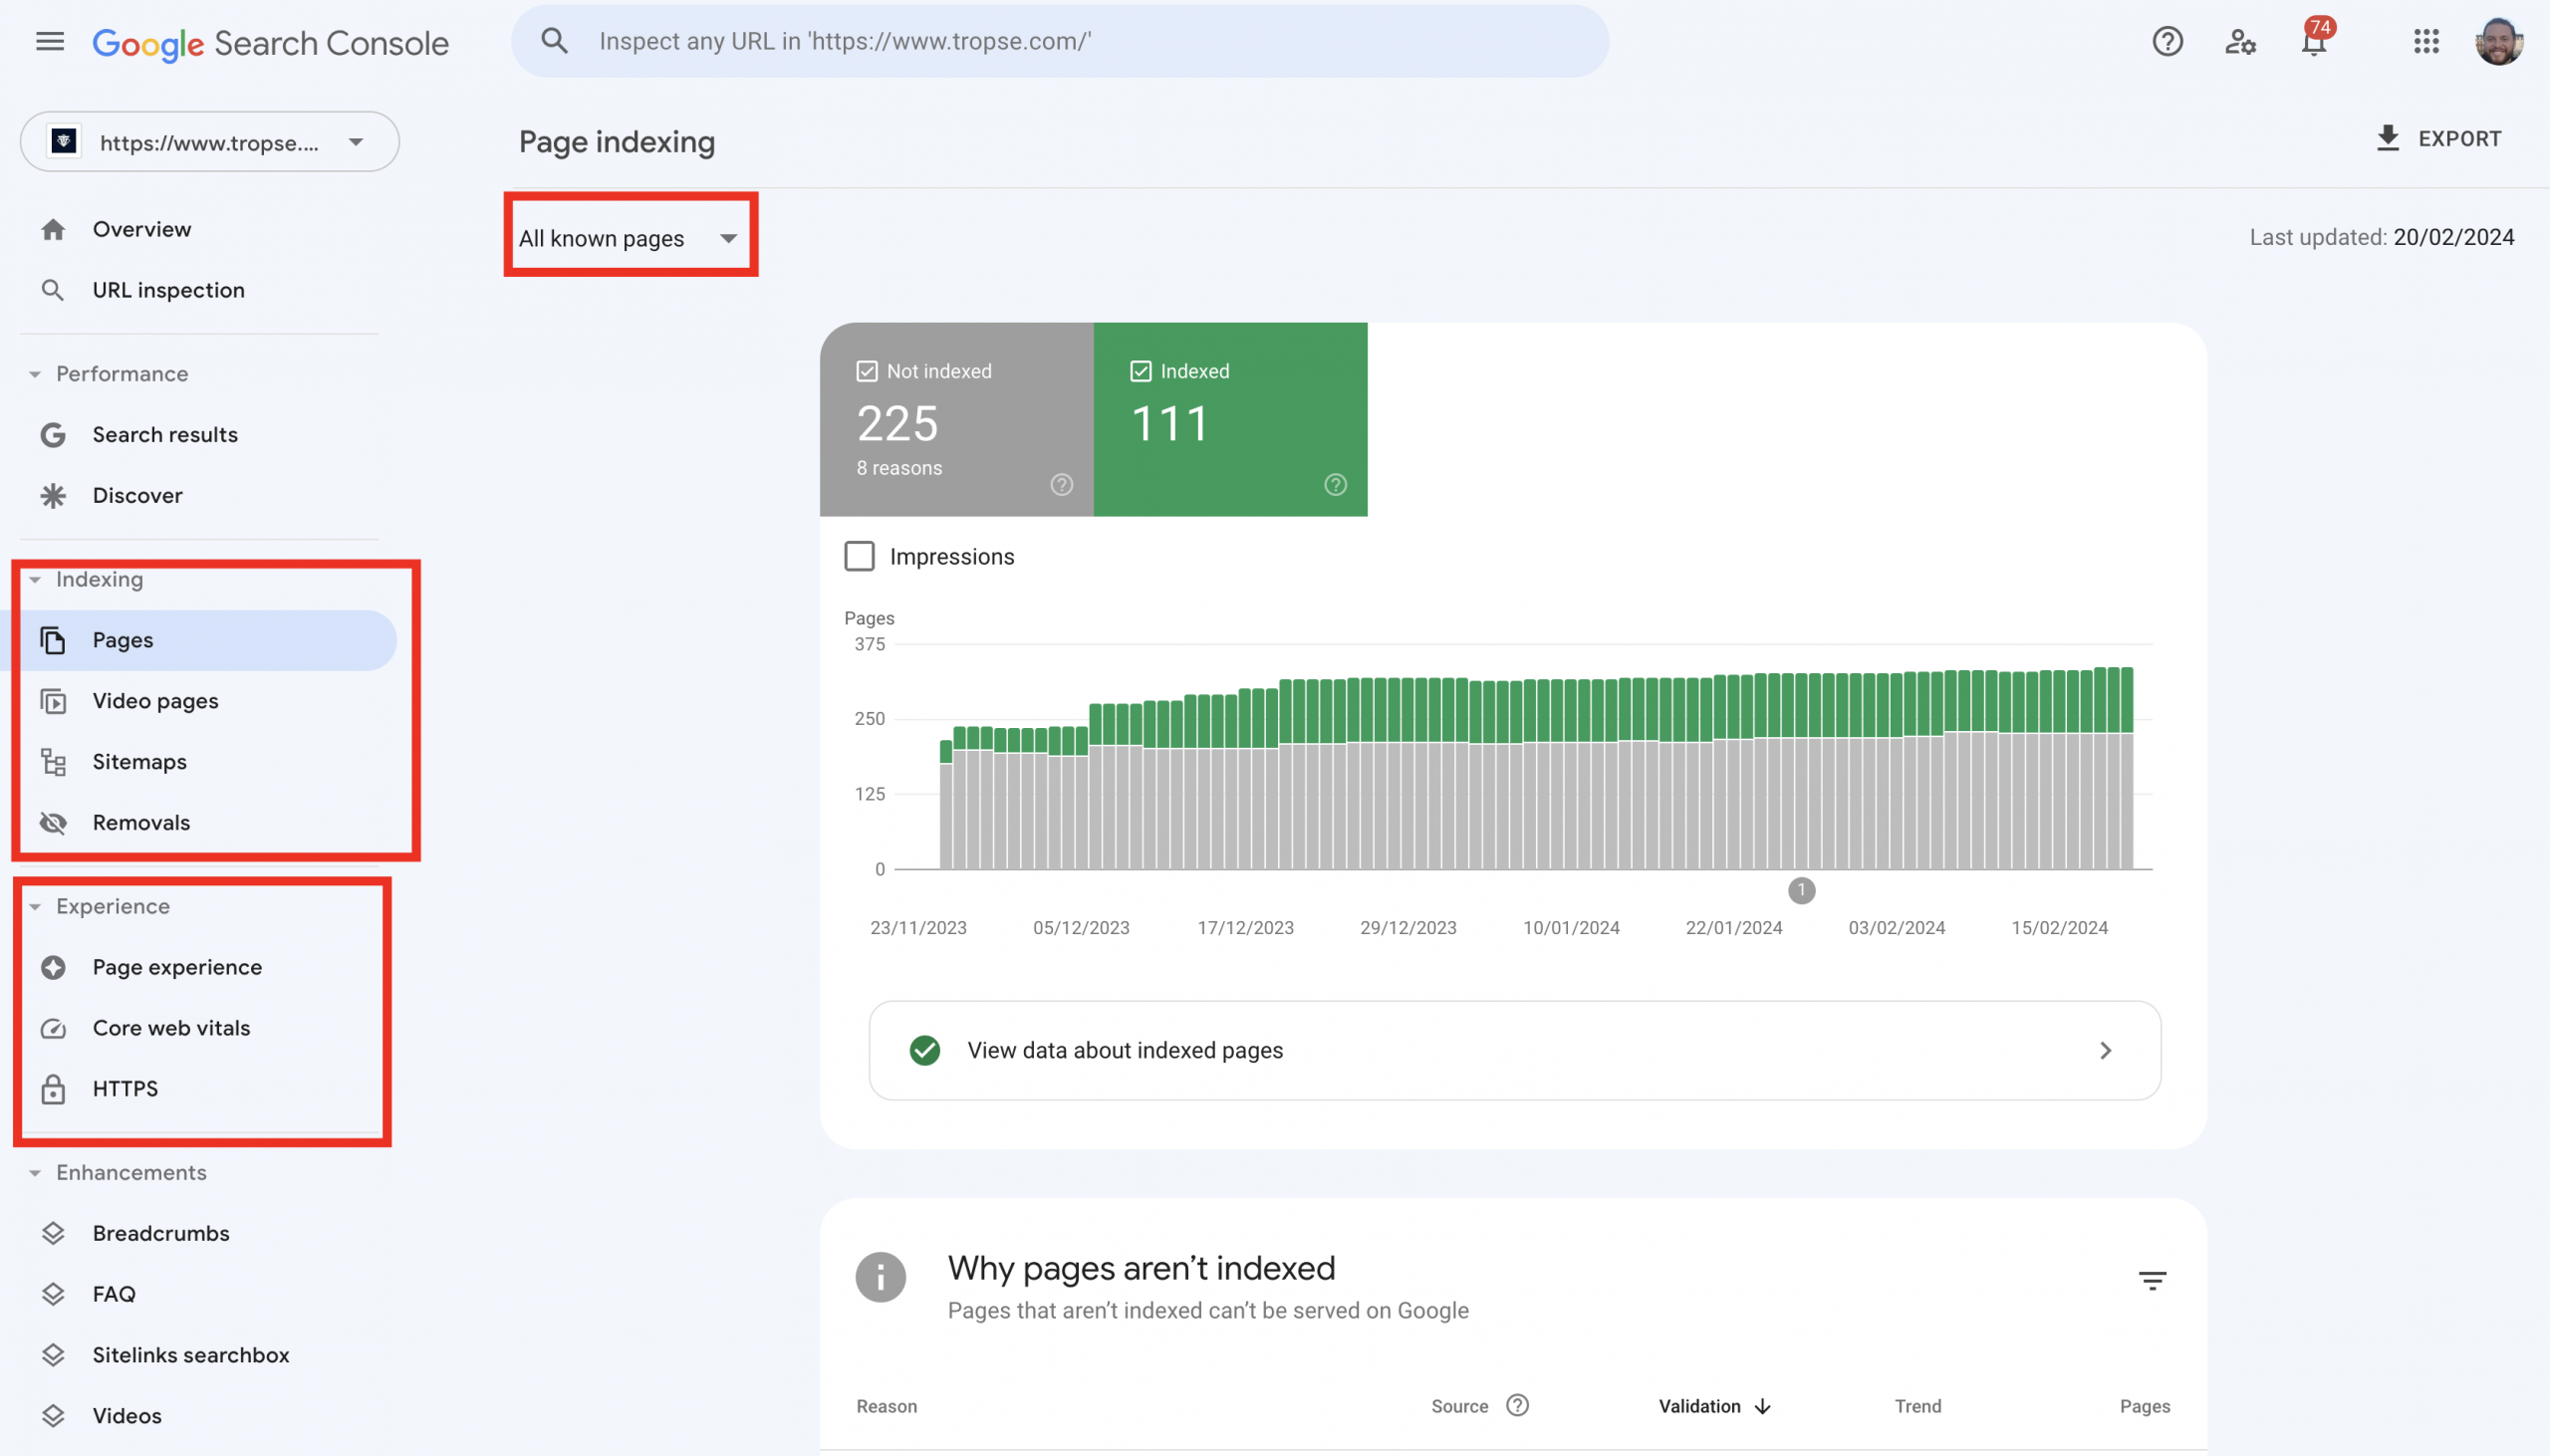
Du hittar den under Indexering > Sidor i Search Console.
Sammanfattningssidan
Överst ligger ett diagram med antal indexerade och icke indexerade sidor över tid. Under det finns tabellerna:
- Why pages aren't indexed — de orsaker som hindrade URL:er från att indexeras. Klickar du på en rad får du en detaljsida med berörda URL:er och historik.
- Improve page experience — problem som inte stoppade indexeringen men som gör det svårare för Google att förstå sidorna.
- View data about indexed pages — historik och en lista med upp till 1 000 indexerade URL:er.
Status, orsak och källa
Varje URL har statusen indexerad eller inte indexerad. En sida som inte är indexerad kan ha ett fel, men den kan också vara utesluten av goda skäl, till exempel för att den är blockerad i robots.txt eller är en dubblett.
Kolumnen Källa visar vem som äger problemet. Står det Webbplats kan du rätta det själv. Står det Google ligger det utanför din kontroll, och då handlar det mest om att ge Google bättre signaler och vänta.
Sitemap-filtret
Ovanför diagrammet finns en rullgardinsmeny som filtrerar på om sidorna finns i en sitemap:
- All known pages (standard) — alla URL:er Google känner till.
- All submitted pages — bara URL:er som finns i en inskickad sitemap.
- Unsubmitted pages only — URL:er som inte finns i någon inskickad sitemap.
- Specific sitemap URL — bara URL:erna i en viss sitemap.
Filtret på inskickade sidor är det jag använder mest. Sidorna i sitemapen är de du själv sagt är viktiga, så det är där ett indexeringsfel kostar mest.
Detaljsidan
Klicka på en rad på sammanfattningssidan så öppnas detaljsidan för den orsaken. Diagrammet visar antal berörda sidor över tid, så du kan följa effekten av en åtgärd. Exempeltabellen är begränsad till 1 000 rader och visar inte nödvändigtvis alla URL:er. Från varje rad kan du öppna sidan, starta URL-granskning eller kopiera adressen. Du kan också dela detaljsidan och exportera både diagram och tabell.
Ser du en URL med ett problem du redan rättat, kolla crawldatumet. Är det äldre än åtgärden har Google helt enkelt inte varit där sedan dess, och du kan begära ny indexering.
Validera dina åtgärder
När du rättat alla förekomster av ett problem öppnar du detaljsidan och klickar på Validate fix. Enligt Google tar valideringen normalt upp till ungefär två veckor, ibland längre. Du får besked när den lyckats eller misslyckats.
Därför är validering värt att göra:
- Du får mejl när Google bekräftar åtgärden eller hittar kvarvarande fel.
- Du kan följa status per URL under tiden.
- Det är frivilligt. Google uppdaterar antalen även utan validering, så använd omdöme om vilka problem som är värda att driva.
Prioritera problem där källan är din webbplats och där valideringen misslyckats eller inte startats. Ett tips för att snabba på: skicka in en sitemap med just de viktiga sidorna och filtrera rapporten på den.
Felsökning steg för steg
- Klicka på en rad i tabellen Why pages aren't indexed.
- Bedöm om orsaken faktiskt är ett problem, utifrån vilka sidor du vill ha indexerade.
- Kolla källan för att se om du kan rätta det själv.
- Läs Googles förklaring av just den orsaken via länken på detaljsidan.
- Öppna URL-granskning för en exempel-URL och läs crawl- och indexeringsdetaljerna.
- Klicka på Test live URL för att se om problemet finns kvar i den nuvarande versionen av sidan.
Orsakerna och hur du löser dem
Namnen nedan är de som står i rapporten. Jag skriver dem på engelska eftersom det är så de flesta ser dem.
Server error (5xx)
Servern kunde inte svara på Googles anrop. De vanligaste orsakerna är överbelastning, när servern får fler anrop än den klarar, och felkonfiguration, som fel behörigheter eller trasiga konfigurationsfiler. Upprepade 5xx-fel gör också att Google sänker crawltakten, så det här är ett av felen jag åtgärdar först.
Redirect error
Google stötte på en trasig omdirigering: en kedja som är för lång, en loop, en URL som blir för lång eller en tom eller felaktig URL i kedjan. Följ omdirigeringen i ett verktyg som Lighthouse eller en crawler och peka den gamla adressen direkt mot slutmålet.
URL blocked by robots.txt
Robots.txt hindrar Google från att hämta sidan. Kontrollera filen i robots.txt-rapporten under Inställningar i Search Console. Den ersatte det gamla robots.txt-testverktyget i slutet av 2023. Observera att en blockerad sida ändå kan hamna i indexet om Google hittar information om den på annat håll. Vill du garanterat hålla den utanför ska du ta bort blockeringen och använda noindex i stället, eftersom Google måste kunna läsa sidan för att se taggen.
URL marked 'noindex'
Sidan har en noindex-instruktion, i en metatagg eller i HTTP-headern. Ska den vara indexerad tar du bort instruktionen. Bekräfta via URL-granskningen att det är noindex som stoppar indexeringen, och kör sedan Test live URL för att se om taggen fortfarande finns i liveversionen. Jag har sett många sajter där en noindex från staging följt med till produktion.
Soft 404
Sidan svarar 200 men ser ut som en felsida för Google, till exempel en tom kategori eller ett meddelande om att produkten inte finns. Lösningen beror på vad som hänt:
- Innehållet finns inte längre: låt sidan svara 404 och visa ett tydligt meddelande till besökaren.
- Innehållet har flyttat: sätt en 301 till den nya adressen och uppdatera interna länkar som pekar på den gamla.
Blocked due to unauthorized request (401)
Sidan kräver inloggning, och Googlebot loggar aldrig in. Ta bort behörighetskravet om sidan ska indexeras, eller släpp igenom Googlebot efter att ha verifierat att anropet verkligen kommer från Google. Testa sidan i ett inkognitofönster för att se vad en utloggad besökare får. Vissa servrar svarar också felaktigt 401 när en IP-adress är spärrad.
| Kod | Namn | Betydelse |
|---|---|---|
| 401 | Unauthorized | Autentisering krävs och saknas eller misslyckades. |
| 403 | Forbidden | Anroparen har inte behörighet till resursen. |
| 404 | Not found | Resursen finns inte på servern. |
Not found (404)
Google hittade URL:en via en länk eller för att sidan funnits tidigare. Googlebot fortsätter försöka ett tag men allt mer sällan. En 404 är inte ett fel i sig om sidan tagits bort utan ersättning. Har sidan flyttat sätter du en 301 till den nya adressen. Rätta alltid 404:or som du själv länkar till eller har med i sitemapen.
Blocked due to access forbidden (403)
Servern nekade åtkomst. Eftersom Googlebot aldrig skickar inloggningsuppgifter är det här i praktiken en felkonfiguration. Tillåt utloggade besökare, eller tillåt Googlebot efter att ha verifierat dess identitet.
URL blocked due to other 4xx issue
Servern svarade med en annan 4xx-kod. Använd URL-granskningen för att se exakt vilken kod det gäller, och kontrollera att interna länkar inte pekar på trasiga adresser.
Crawled – currently not indexed
Google har besökt sidan men valt att inte indexera den, åtminstone inte än. Det här är ofta en kvalitetsfråga: tunt innehåll, innehåll som liknar andra sidor för mycket, eller sidor som inte tillför något för den som söker. Förbättra innehållet eller slå ihop det med en starkare sida, och se till att sidan får interna länkar.
Discovered – currently not indexed
Google känner till URL:en men har inte crawlat den. Enligt Google beror det ofta på att en crawl skulle ha överbelastat sajten, så den sköts upp. Därför saknas crawldatum i rapporten. På en mindre sajt brukar det lösa sig med tiden. Ligger tusentals URL:er här länge på en stor sajt är det ett tecken på att crawl budget börjar bli en begränsning.
Alternate page with proper canonical tag
Sidan är en alternativ version som pekar på en kanonisk sida, och den kanoniska sidan är indexerad. Det är normalt och inget du behöver göra något åt. Signalerna för att ange kanonisk URL, från starkast till svagast:
- Omdirigeringar — målet för omdirigeringen blir kanoniskt.
rel="canonical"— en stark signal för den angivna URL:en.- Sitemap — en svagare signal för URL:er som finns med i sitemapen.
Signalerna kan kombineras. Använd inte robots.txt eller borttagningsverktyget för att styra kanonisering.
Duplicate without user-selected canonical
Sidan är en dubblett och saknar egen canonical, så Google har valt en annan sida som kanonisk. Tycker du att Google valt fel anger du rätt kanonisk URL. Är sidan inte en dubblett ska innehållet skilja sig tydligt från den sida Google valde.
| Sidans URL | Kanonisk URL |
|---|---|
| https://example.com/duplicate-page | https://example.com/preferred-page |
| https://example.com/duplicate-page-2 | https://example.com/preferred-page |
| https://example.com/duplicate-page-3 | https://example.com/preferred-page |
Duplicate, Google chose different canonical than user
Du har angett en kanonisk URL, men Google har valt en annan. Jämför Google-selected canonical med User-declared canonical i URL-granskningen och öppna alla tre sidorna i webbläsaren. Är den sida du angett inte tillräckligt lik den aktuella sidan kommer Google inte att välja den.
Page with redirect
URL:en omdirigerar, så den indexeras inte själv. Målet för omdirigeringen kan indexeras eller inte beroende på Googles bedömning. Det här är oftast helt i sin ordning. Kontrollera målsidans status genom att granska den separat. Testet i URL-granskningen följer omdirigeringen och testar slutmålet, utan att det står uttryckligen.
Blocked by page removal tool
Någon har begärt borttagning, antingen en ägare av egendomen i Search Console eller en besökare via ett godkänt ärende. Se vem i verktyget Borttagningar (Removals). En tillfällig borttagning gäller i ungefär sex månader. Därefter kan sidan dyka upp igen. Vill du hålla den borta permanent använder du noindex, kräver inloggning eller tar bort sidan.
Varningar på indexerade sidor
Indexed, though blocked by robots.txt
Sidan är indexerad trots att robots.txt blockerar den. Google hämtar inte sidan men kan indexera den utifrån länkar från andra sidor. Utdraget i sökresultatet blir då magert. Vill du ha bort den: ta bort blockeringen och lägg på noindex. Vill du att den ska indexeras ordentligt: ta bort blockeringen.
Page indexed without content
Sidan finns i indexet men Google kunde inte läsa innehållet. Antingen visar sidan annat innehåll för Google än för besökare (cloaking), eller så ligger innehållet i ett format Google inte kan indexera. Det här beror inte på robots.txt, eftersom en blockering hade hindrat indexeringen helt. Granska sidan med URL-granskningen för att se vad Google faktiskt får.
Fler indexerade sidor är inte målet
Målet är att rätt sidor är indexerade. Två saker påverkar det mest:
- Innehåll som förtjänar en plats. Unika sidor som besvarar något målgruppen söker efter indexeras och rankar. Tunna varianter hamnar under Crawled – currently not indexed.
- Struktur. En tydlig webbplatsarkitektur med interna länkar gör att Google hittar sidorna och förstår vilka som är viktigast.
Många av orsakerna ovan, som canonicals, noindex, robots.txt och statuskoder, går jag igenom mer översiktligt i teknisk SEO: 11 grundläggande aspekter. Indexeringsrapporten är också en fast del av min SEO-audit.
Vanliga frågor
Var hittar jag rapporten Sidindexering?
Under Indexering > Sidor i menyn i Google Search Console.
Kan jag be Google indexera en specifik sida?
Ja. Klistra in URL:en i URL-granskningen och klicka på Begär indexering. Det garanterar inte indexering, men sidan hamnar i kön.
Hur märker jag att jag har indexeringsproblem?
Sidor som inte syns i sökresultaten, låg organisk trafik till nya sidor eller plötsliga tapp i antal indexerade sidor. Rapporten Sidindexering visar orsaken.
Vilka grundsteg ska jag ta först?
Kontrollera att sidorna är nåbara för Google, att robots.txt inte blockerar något viktigt, att en uppdaterad XML-sitemap är inskickad och att serverfel och 404:or i sitemapen är åtgärdade.
Vill du ha hjälp att reda ut varför sidor inte indexeras är det en del av det jag gör som SEO-konsult.