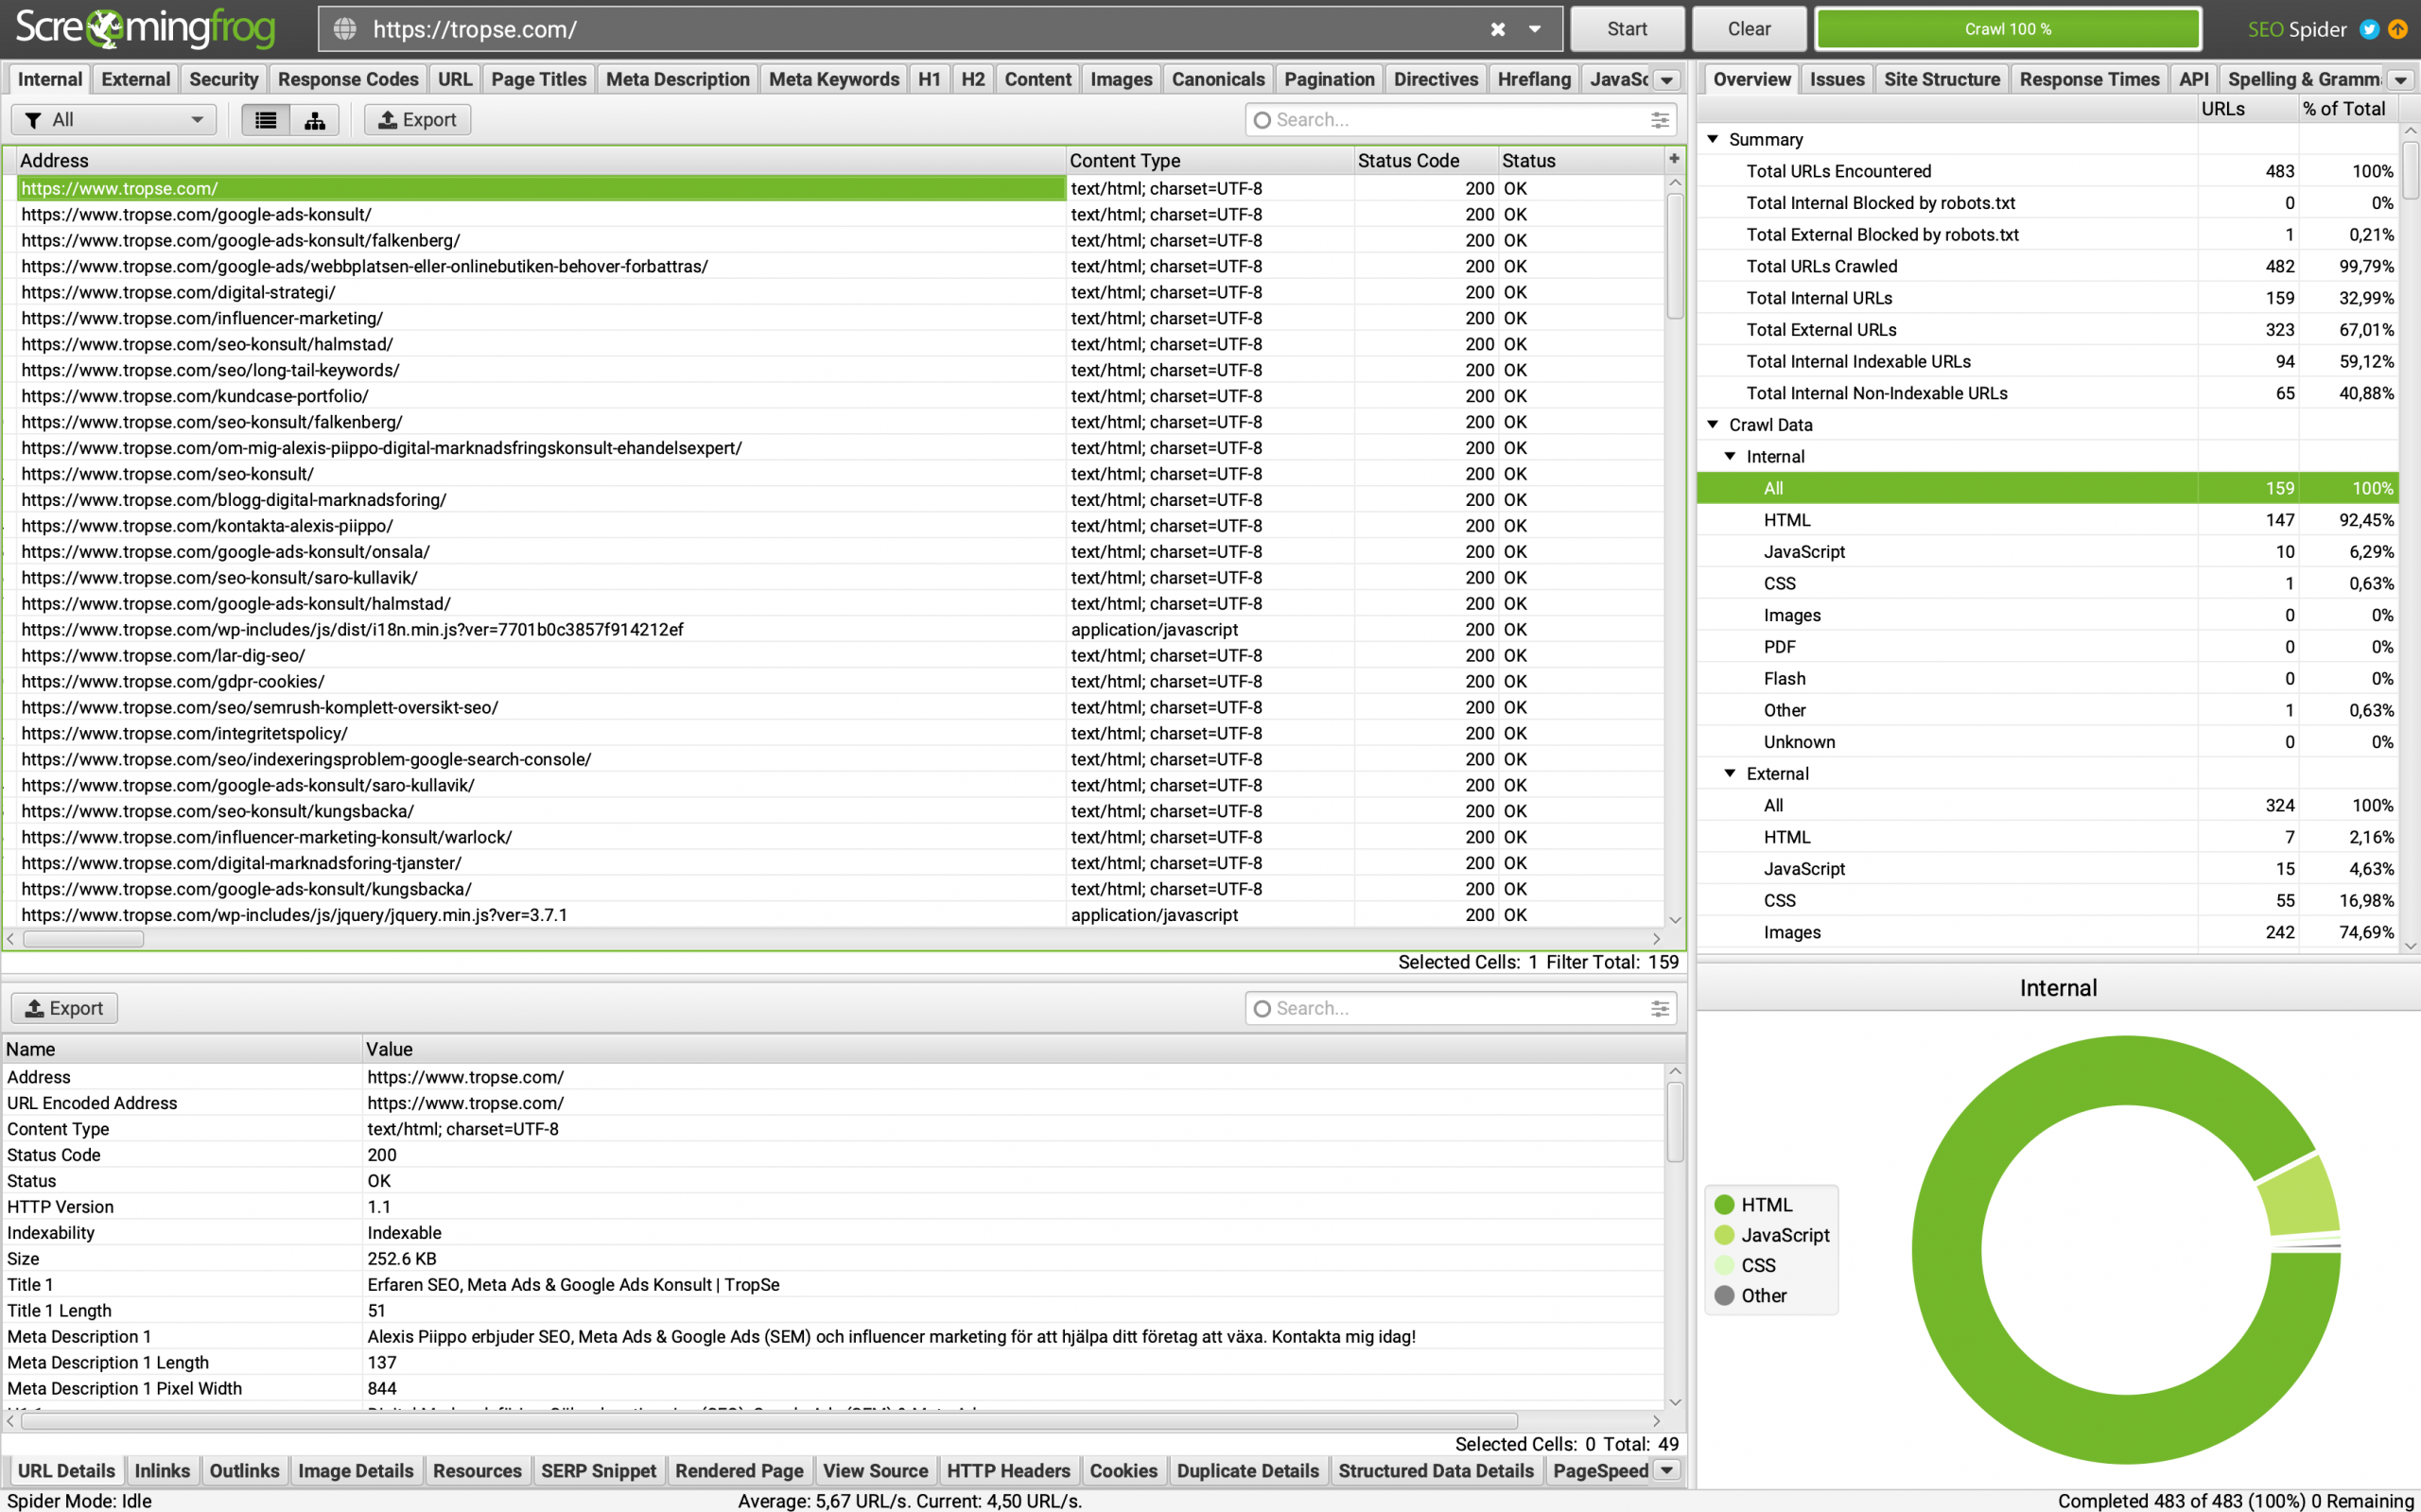
Screaming Frog SEO Spider är ett program du installerar på datorn (Windows, macOS eller Linux). Du ger det en start-URL, och det följer länkarna på sajten ungefär som Googlebot gör. För varje URL det hittar sparar det statuskod, titel, metabeskrivning, rubriker, canonical, robots-direktiv, hreflang, bilder och länkar. Resultatet hamnar i flikar du kan filtrera och exportera.
Det är inget magiskt verktyg. Det visar hur sajten ser ut för en crawler, och sedan är det upp till dig att avgöra vad som spelar roll. Jag har använt det i åratal och det är fortfarande där jag börjar varje teknisk granskning.
Gratis eller licens
Gratisversionen crawlar upp till 500 URL:er. Den hittar trasiga länkar, fel och omdirigeringar, visar titlar och metadata, robots-direktiv, hreflang och exakta dubbletter, och kan generera en XML-sitemap. För en liten företagssajt räcker det långt.
Licensen tar bort taket (i praktiken begränsas du av datorns minne och lagring) och låser upp det mesta jag använder i skarpa uppdrag:
- JavaScript-rendering — nödvändigt om sajten bygger innehållet med React, Vue eller liknande.
- Spara och öppna crawls samt jämföra två crawls mot varandra.
- Nära dubbletter, inte bara exakta.
- Custom extraction och egen sökning i källkoden.
- Validering av strukturerad data.
- Integrationer mot Google Analytics, Search Console och PageSpeed Insights.
- Schemalagda crawls och AI-integrationer (OpenAI och Gemini) för egna promptar per URL.
Licensen kostar 279 dollar per användare och år enligt prissidan när jag skriver det här. Har sajten fler än 500 URL:er, eller renderas innehållet med JavaScript, behöver du den. En e-handel med filter och produktvarianter passerar 500 URL:er snabbt.
Så ställer jag in crawlen
Standardinställningarna fungerar för en första körning, men jag ändrar nästan alltid några saker innan jag kör på en kunds sajt:
- User agent. Jag crawlar som Googlebot Smartphone, eftersom Google indexerar mobilversionen.
- JavaScript-rendering. Påslaget om sajten är byggd i ett JS-ramverk. Jämför gärna en crawl med och utan rendering: skiljer sig antalet länkar eller textmängden mycket beror sajten på JavaScript för innehåll som Google måste rendera för att se.
- XML-sitemaps. Jag låter verktyget läsa sitemapen också. Då ser jag URL:er som ligger i sitemapen men inte länkas internt, och tvärtom.
- Search Console och GA4 via API. Med klick och sessioner per URL bredvid crawldatan vet jag vilka fel som sitter på sidor med trafik.
- Hastighet. Jag drar ner antalet trådar på små eller sköra servrar. En crawl ska inte sänka kundens sajt.
Har du bara en lista med URL:er att kontrollera, till exempel efter en migrering, byter du läge från Spider till List och klistrar in listan.
Rapporterna jag läser först
- Response Codes. Interna länkar till 404:or och 5xx-fel, och omdirigeringskedjor. Här hittar jag nästan alltid något.
- Directives och Canonicals. Sidor med noindex som borde indexeras, och canonicals som pekar på omdirigerade eller trasiga adresser.
- Page Titles och Meta Description. Saknade, dubblerade och för långa. Verktyget mäter längden i pixlar, vilket ligger närmare hur Google kortar av än att räkna tecken.
- H1. Saknade eller dubblerade rubriker, ofta ett tecken på en mall som inte skriver ut rätt fält.
- Content. Exakta och nära dubbletter och sidor med väldigt lite text. På e-handel är det oftast filter- och variant-URL:er.
- Images. Saknad alt-text och stora filer.
- Crawl depth och Inlinks. Viktiga sidor som ligger många klick från startsidan eller har få interna länkar.
Sidhastighet mäter Screaming Frog inte själv. Den data kommer från PageSpeed Insights-integrationen, och då är det Googles egna mätvärden du ser.
Custom extraction
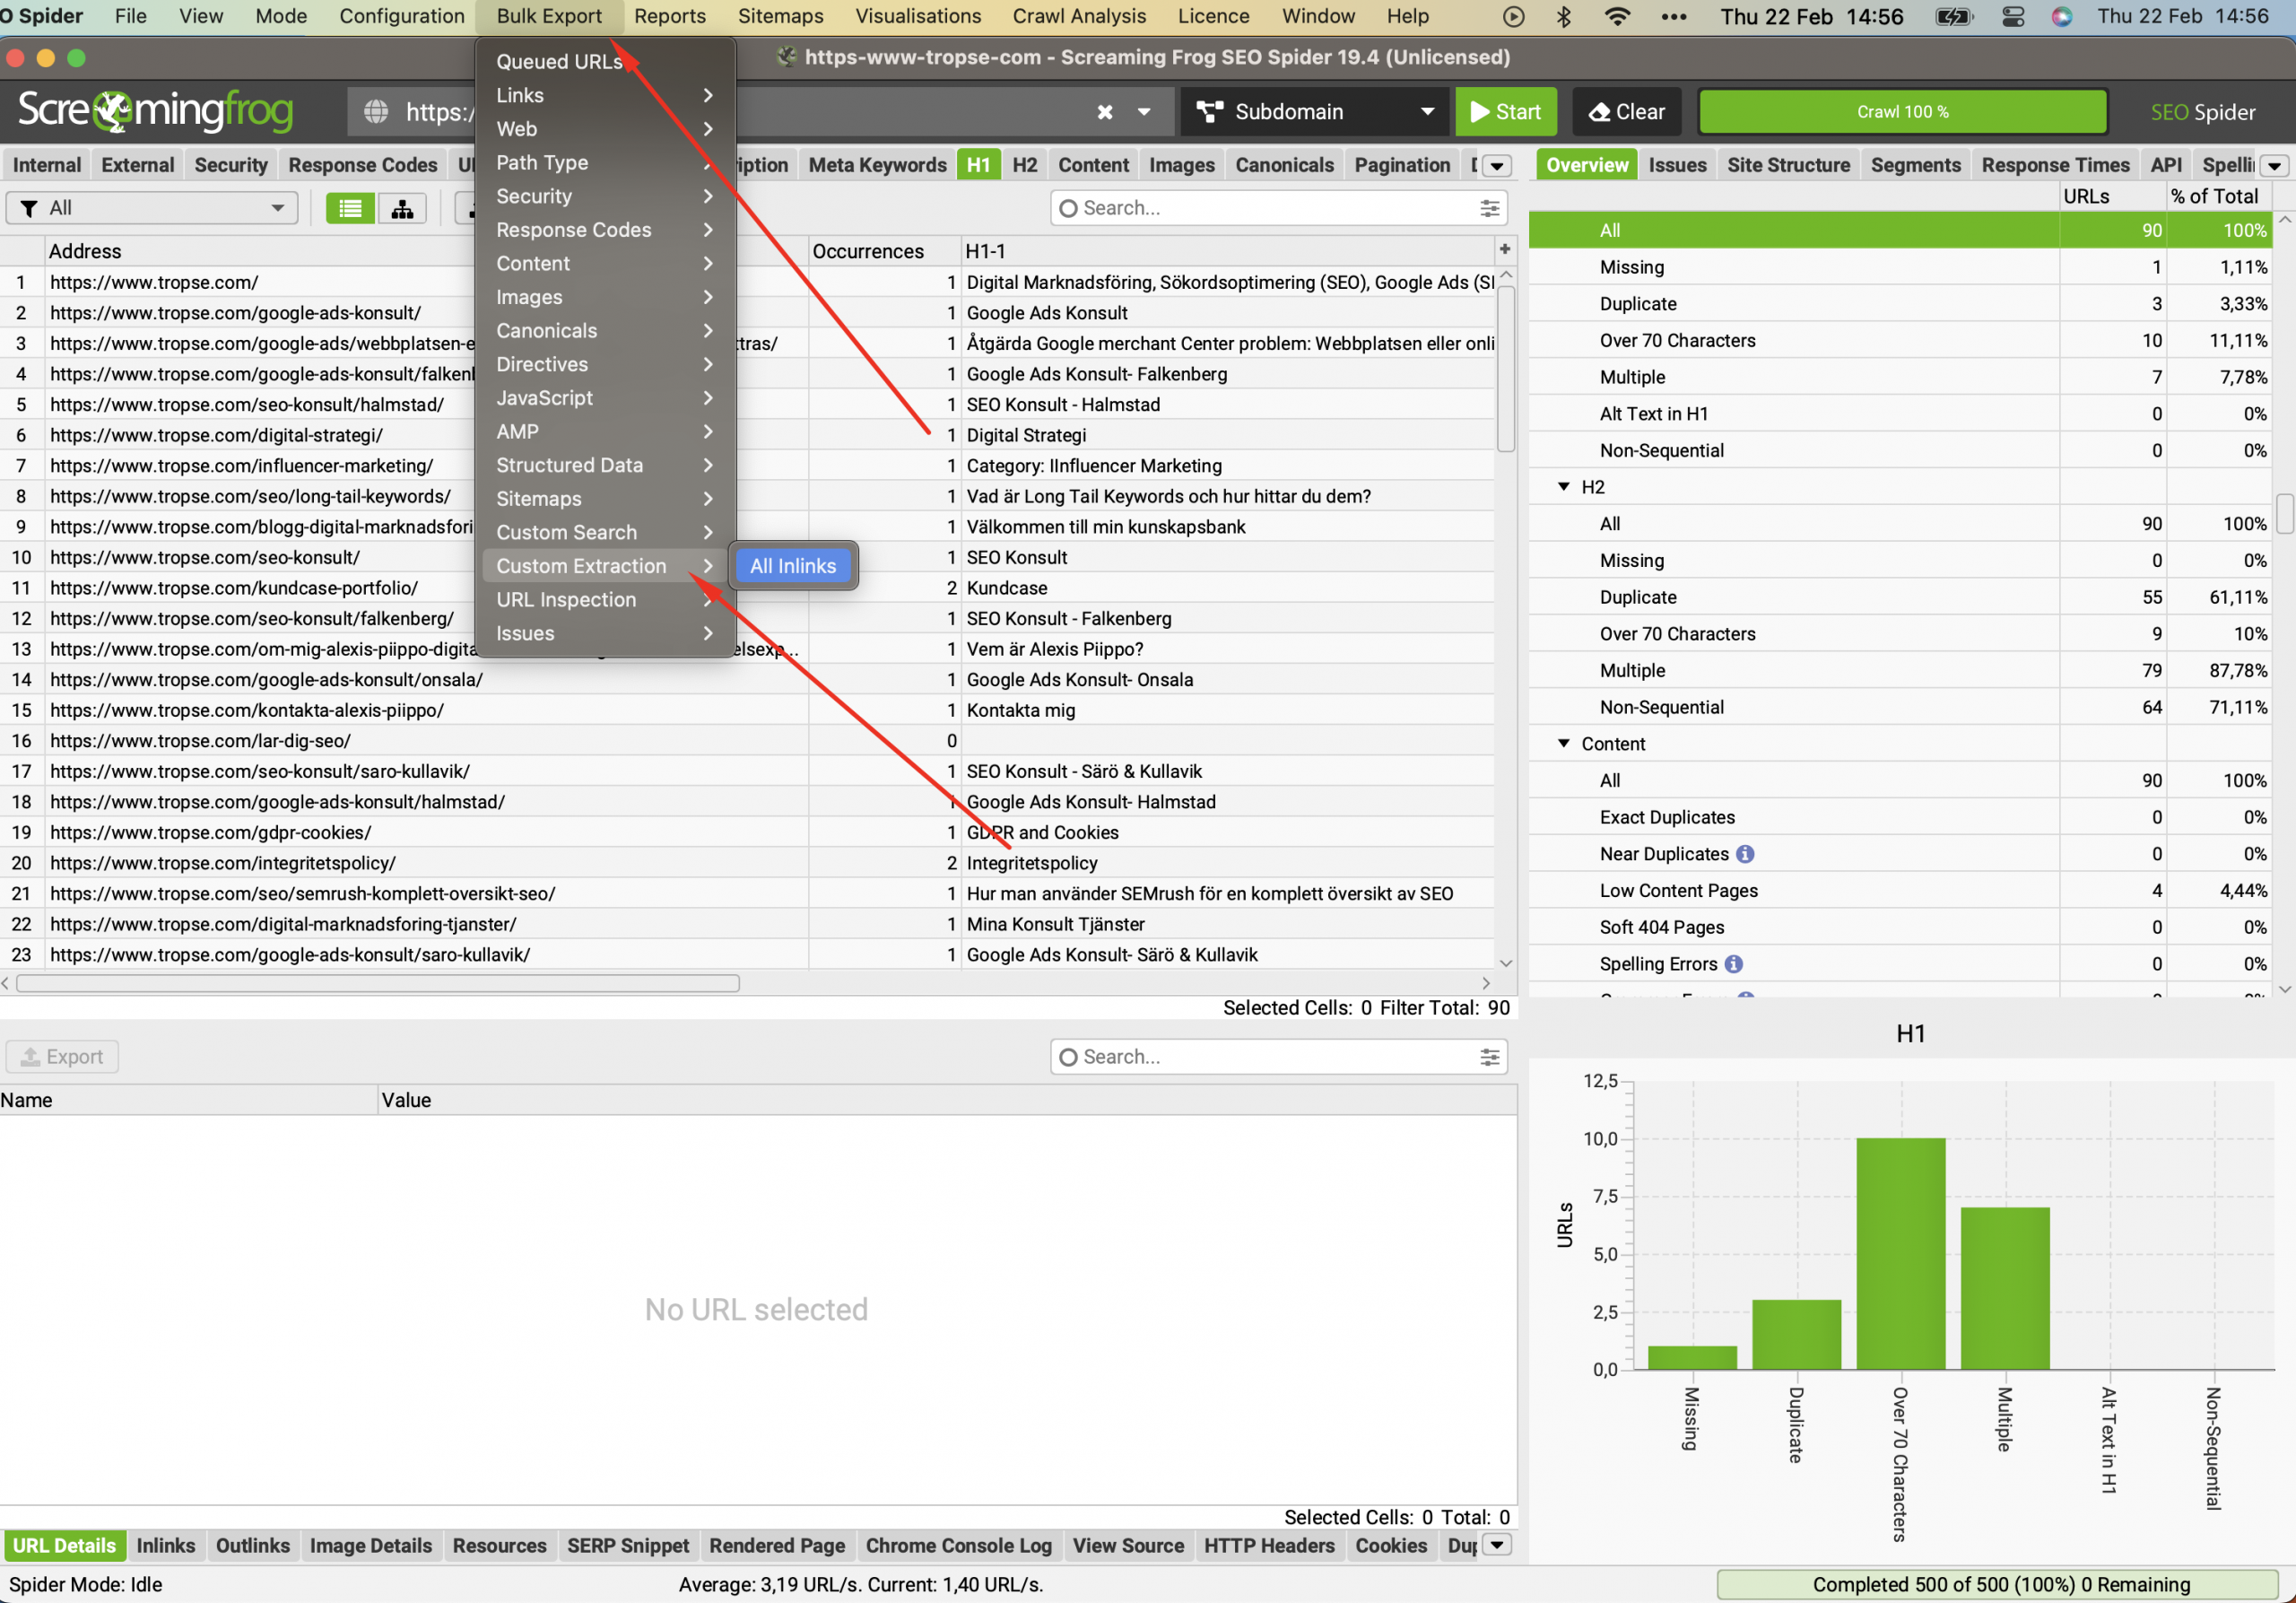
Det här är funktionen som gör verktyget användbart långt utanför standardkontrollerna. Med XPath, CSS-selektorer eller regex hämtar du vad som helst ur sidornas HTML: pris, lagerstatus, författare, publiceringsdatum, antal produkter i en kategori eller om en viss kodsnutt finns med. Jag använder det för att hitta kategorisidor utan brödtext, produktsidor som saknar strukturerad data och artiklar utan författare.
Från crawl till åtgärdslista
En crawl på en medelstor e-handel ger tusentals flaggor. Det är lätt att leverera exporten och kalla det en audit. Det hjälper ingen. Så här sorterar jag:
- Fel som stoppar indexering på sidor som ska ranka: noindex, felaktiga canonicals, blockering i robots.txt, 5xx.
- Fel på sidor med trafik, sorterat på klick från Search Console.
- Mallfel. Ett problem i en produktmall syns på tusen URL:er men är en enda ändring för utvecklaren. Jag grupperar per mall, inte per URL.
- Resten, som enskilda titlar som är några pixlar för långa, tar jag sist eller inte alls.
När ändringarna är gjorda kör jag en ny crawl och jämför med den gamla. Då ser jag vad som faktiskt rättades och om något nytt gick sönder på vägen. Hela granskningen, där crawlen är en del, går jag igenom i SEO-audit: en komplett guide. De tekniska grunderna som crawlen kontrollerar hittar du i teknisk SEO: 11 grundläggande aspekter.
Vanliga frågor
Är Screaming Frog gratis?
Upp till 500 URL:er per crawl, med grundfunktionerna. Allt över det, och funktioner som JavaScript-rendering och integrationer, kräver en årslicens.
Vad skiljer det från Ahrefs eller Semrush site audit?
Screaming Frog körs lokalt på din dator och du styr exakt hur crawlen går till. Molnverktygens site audit är enklare att schemalägga och dela men ger mindre kontroll. Jag använder båda: molnverktyget för löpande bevakning, Screaming Frog när något ska redas ut på riktigt.
Klarar min dator en stor crawl?
Hur många URL:er du kan crawla styrs av tilldelat minne och lagring. För stora sajter lönar det sig att spara crawlen på disk i stället för i minnet. Screaming Frogs FAQ beskriver inställningarna.
Kan jag skada sajten med en crawl?
En aggressiv crawl mot en svag server kan göra den långsam medan crawlen pågår. Sänk hastigheten och kör utanför kontorstid om du är osäker.
Vill du hellre att någon annan kör och tolkar crawlen gör jag det som SEO-konsult.